
YomiToku v0.16.3で提供する幾何補正モデルPageNetV2を紹介します。写真に写った複数の書類を1枚ずつ検出し、レシートの湾曲やスキャン画像の傾きを補正してから解析します。モデルの構成、最適化の方針、解析例、CLIとPython APIでの使い方を解説します。
MLism代表の木之下です。文書解析の入力は、必ずしも平らでまっすぐな画像とは限りません。スマートフォンで撮影した書類の画像には傾きや歪みが含まれることが多く、スキャン画像も少し傾いて取り込まれることがあります。YomiToku v0.16.3では、このような画像を解析する前に紙の歪みや傾きを補正する幾何補正モデル PageNetV2 をリリースしました。
PageNetV2は、1枚の写真に写った複数の書類(見開きの左右のページ、並べたレシートや名刺、A4の書類など)を1枚ずつ検出し、それぞれの紙の曲がりや傾きを補正します。補正後の画像に対して、ページごとにOCRやレイアウト解析を行えます。本記事では、これまでの課題、ベースとなった既存研究UVDoc、PageNetV2の技術的な概要、解析例、使い方を紹介します。
これまでの課題
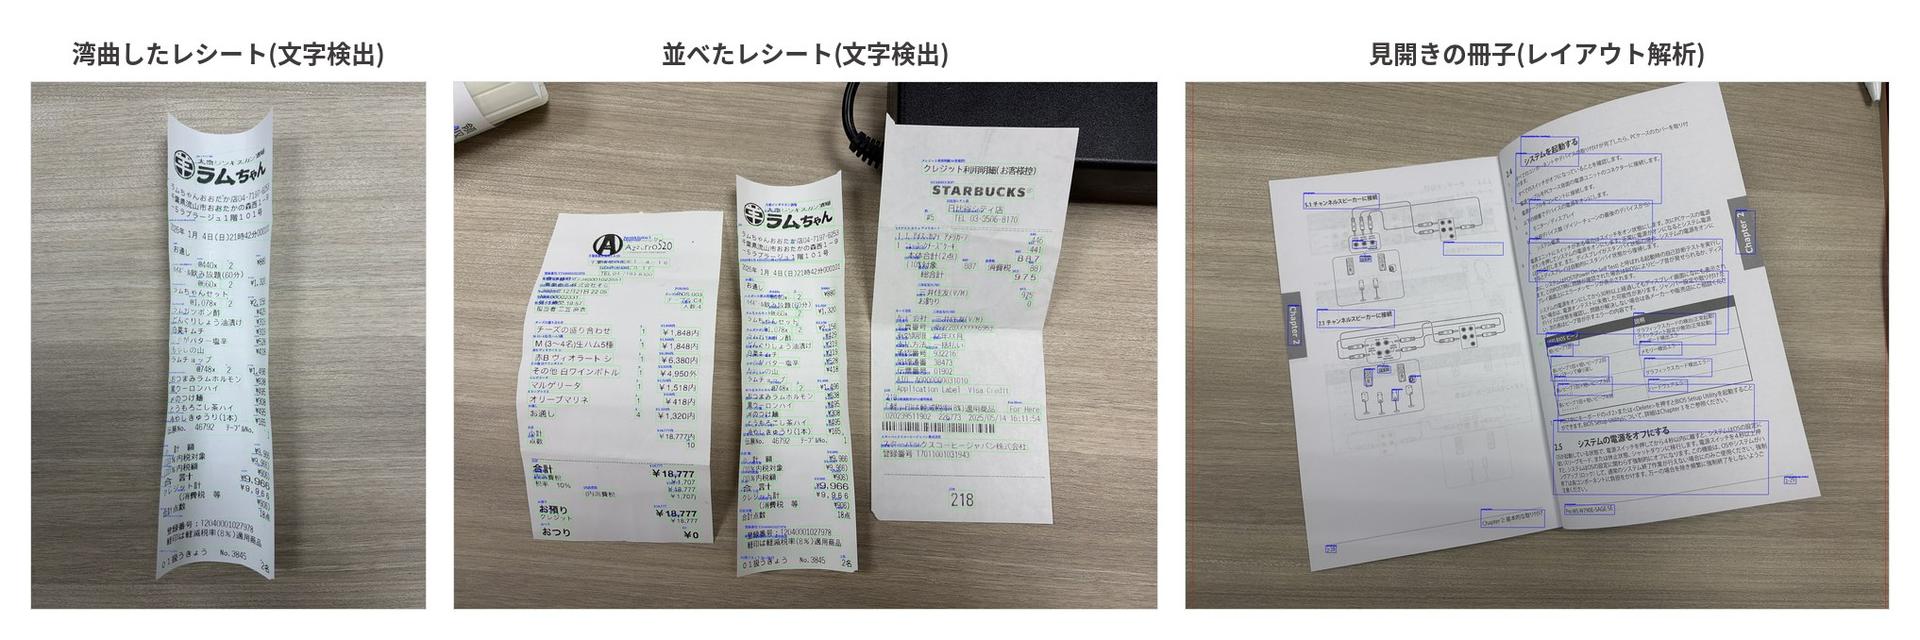
YomiTokuのOCRとレイアウト解析は、平らでまっすぐな文書画像を主な対象としていました。そのため、カメラで撮影した書類を入力すると、次のような問題が起こります。
- 歪んだ文字列の座標を矩形で表現できない:カールしたレシートや湾曲した冊子では、1行の文字列が曲線を描きます。文字列を四角形で囲む検出方式では、隣の行を巻き込んだり、行の途中で領域が分断されたりすることがあります。
- レイアウト解析と表構造解析が傾きに対応していない:段落、表、セルは画像の縦横の軸に沿った矩形領域として推定するため、傾いたページや曲がったページでは正確な位置を予測できず、領域どうしが重なってしまいます。また、表の行や列の対応関係の推定も崩れます。
- 写真の背景がノイズになる:机の模様や汚れ、背景や隣に写り込んだ別の書類の文字まで読み取ってしまいます。
- 複数のページを区別できない:見開きの冊子や並べたレシートを1枚の画像として解析するため、ページをまたぐ場合の読み順の推定精度が低下します。
幾何補正モデルによる対策
そこで、解析の前処理として幾何補正モデルを構築し、提供を開始しました。写真の中から書類を1枚ずつ検出し、それぞれの歪みや傾きを補正して平らな紙面の画像に変換してから、OCRやレイアウト解析を行います。
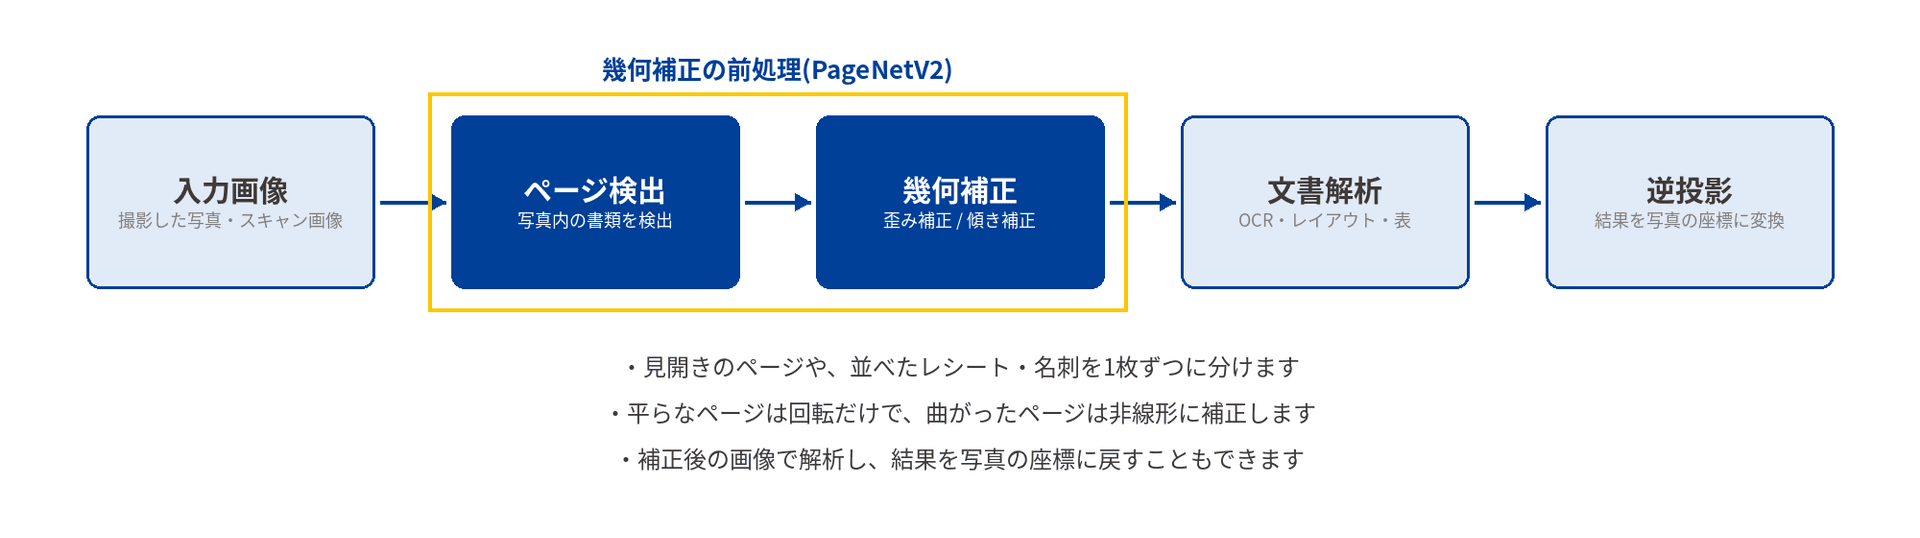
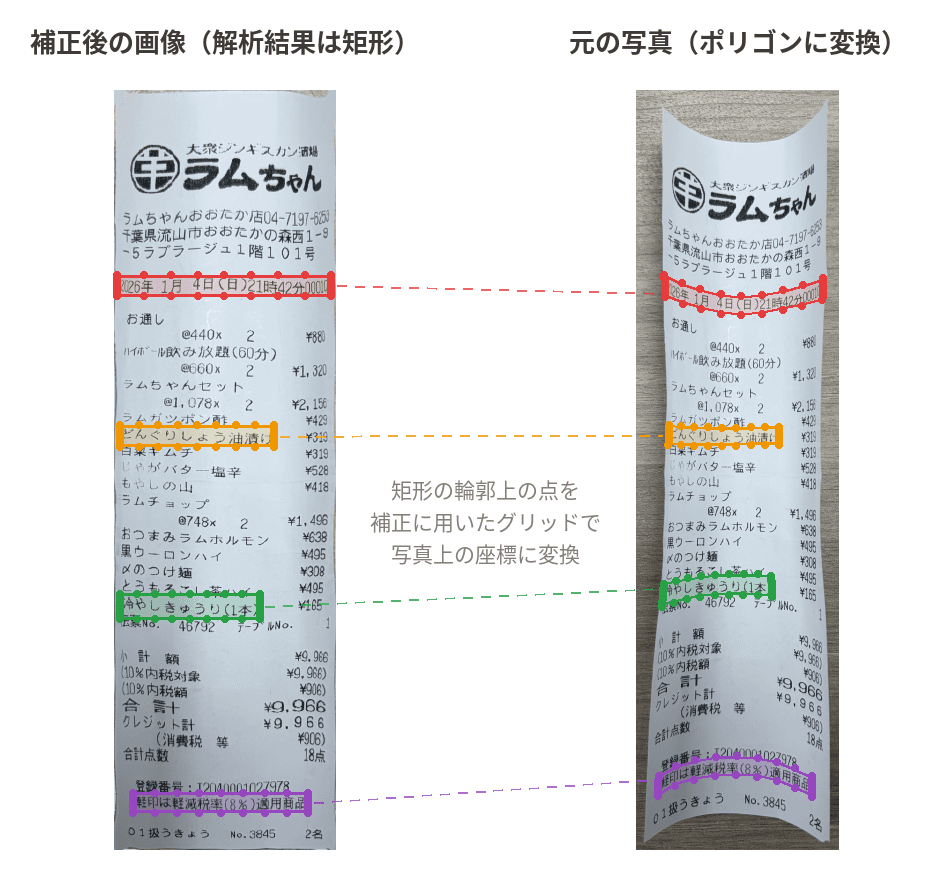
解析は補正後の画像に対して行うため、既存のOCR、レイアウト解析、表構造解析のモデルをそのまま活用できます。さらに、補正後の画像で得た解析結果を元の写真の座標に変換(逆投影)し、ポリゴンとして出力することで、湾曲した文字列や傾いた領域の位置も正確に表現できるようになりました。
逆投影では、補正後の画像で得た矩形の輪郭上に点を取り、各点を補正に用いたグリッドで写真上の座標に変換します。変換後の点を結んだポリゴンは紙の曲がりに沿うため、写真上でも文字列や領域の位置を正確に表せます。
既存研究の紹介: UVDoc
文書画像の幾何補正については、画像処理による手法や機械学習を用いた手法など、これまでに多くの研究があります。PageNetV2のうち、ページごとに歪みを補正する部分は、UVDoc(Verhoeven et al., 2023)を参考にしています。
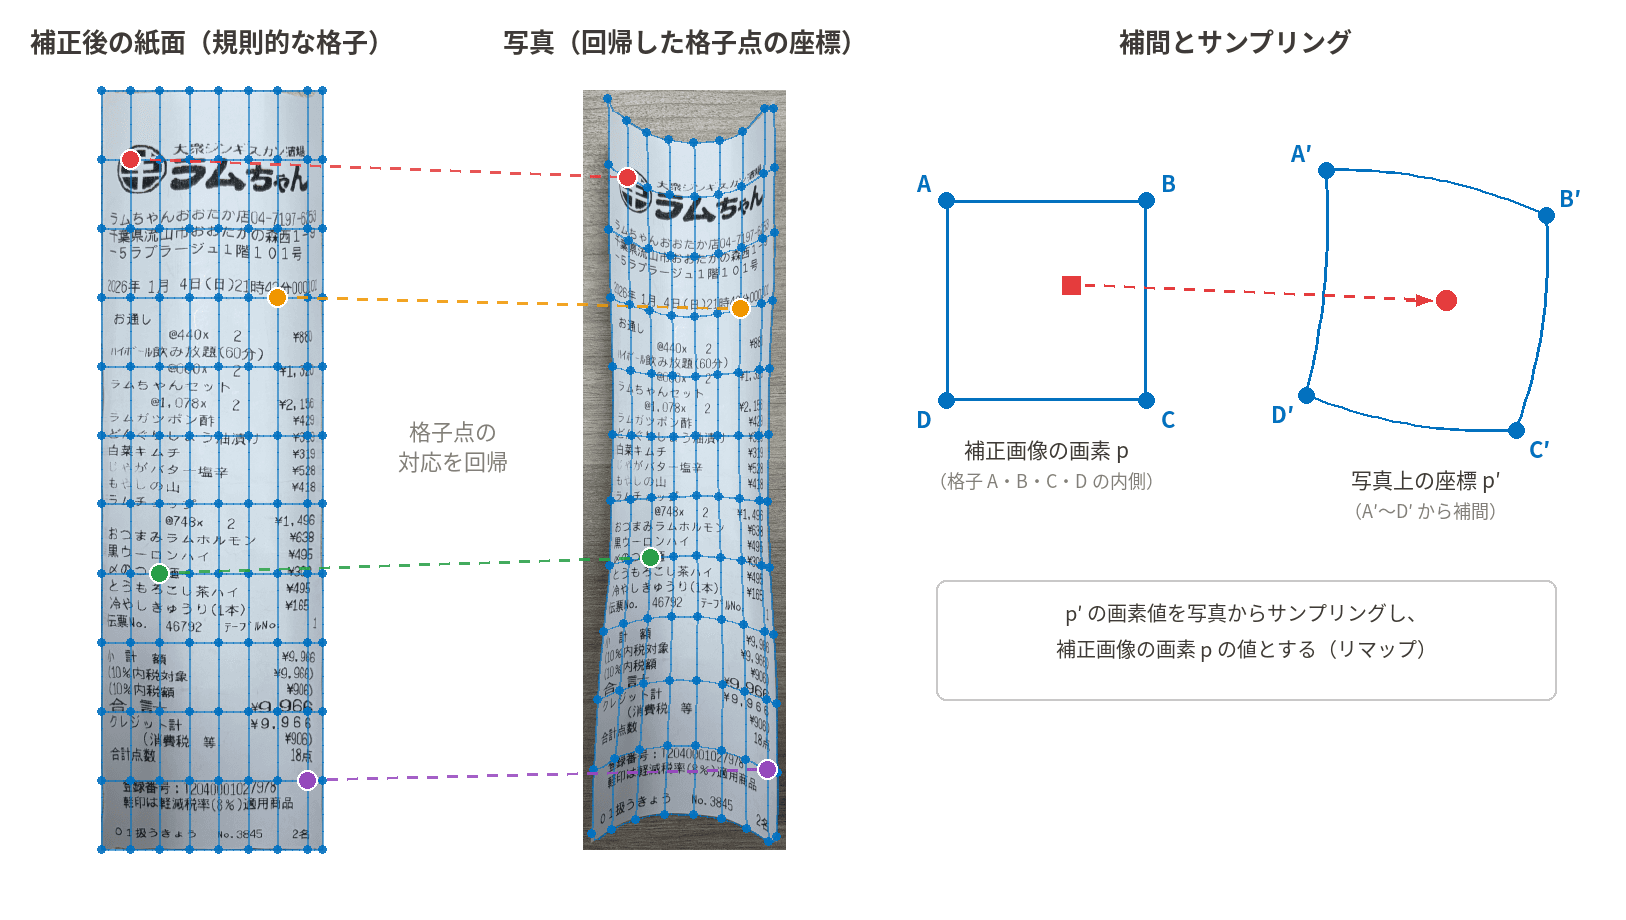
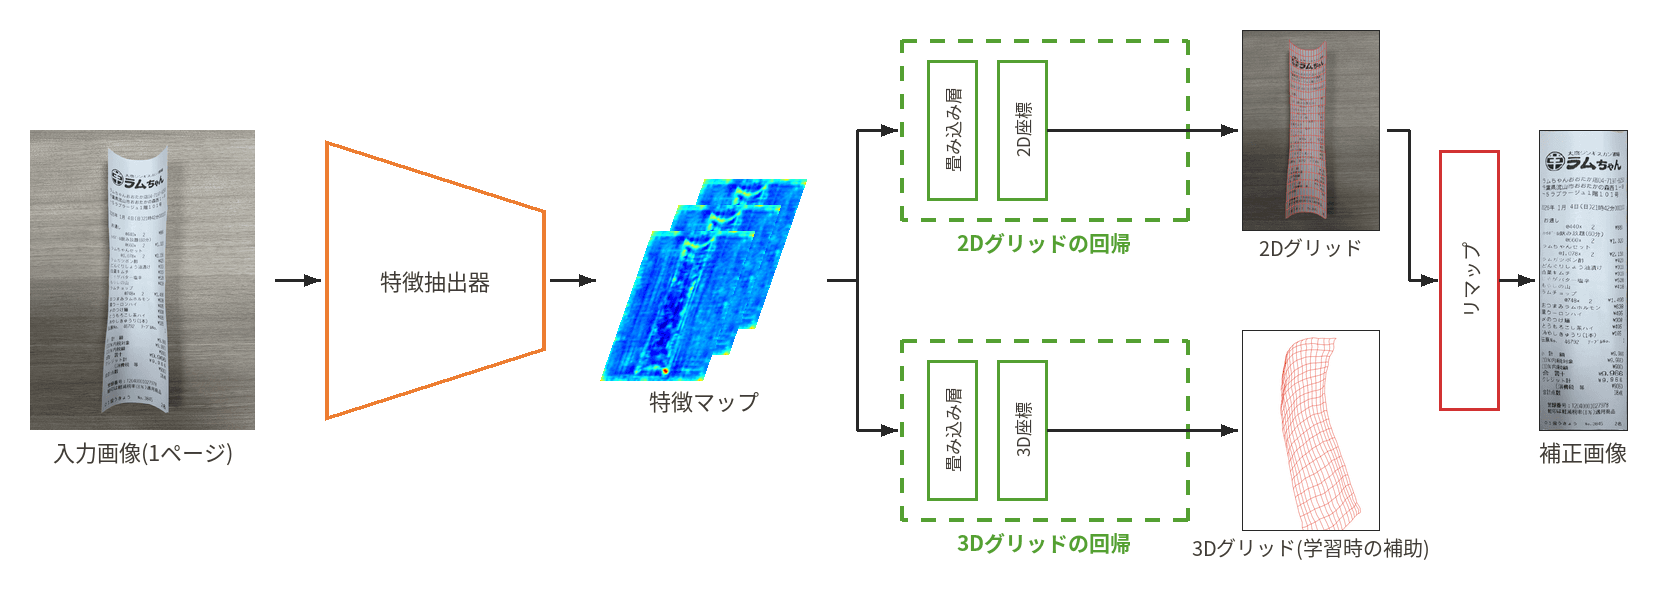
UVDocは、幾何補正を「補正後の平らな紙面上に定義した規則的な格子(グリッド)の各点が、写真上のどの座標に対応するか」を推定する問題として扱います。紙面上で等間隔に並んだ格子点(例えば45×31点)について、写真上の座標をニューラルネットワークで回帰します。格子点の対応が得られれば、その間を補間して補正画像の各画素に対応する写真上の座標を求め、写真から画素値をサンプリング(リマップ)することで、補正画像を生成できます。
UVDocのアーキテクチャを次の図に示します。写真全体を1枚のページとして扱い、特徴抽出器で得た特徴マップから、2Dグリッドと3Dグリッドをそれぞれ回帰します。2Dグリッドは格子点の写真上の2次元座標、3Dグリッドは紙の3次元形状を表します。補正画像の生成には2Dグリッドを使います。
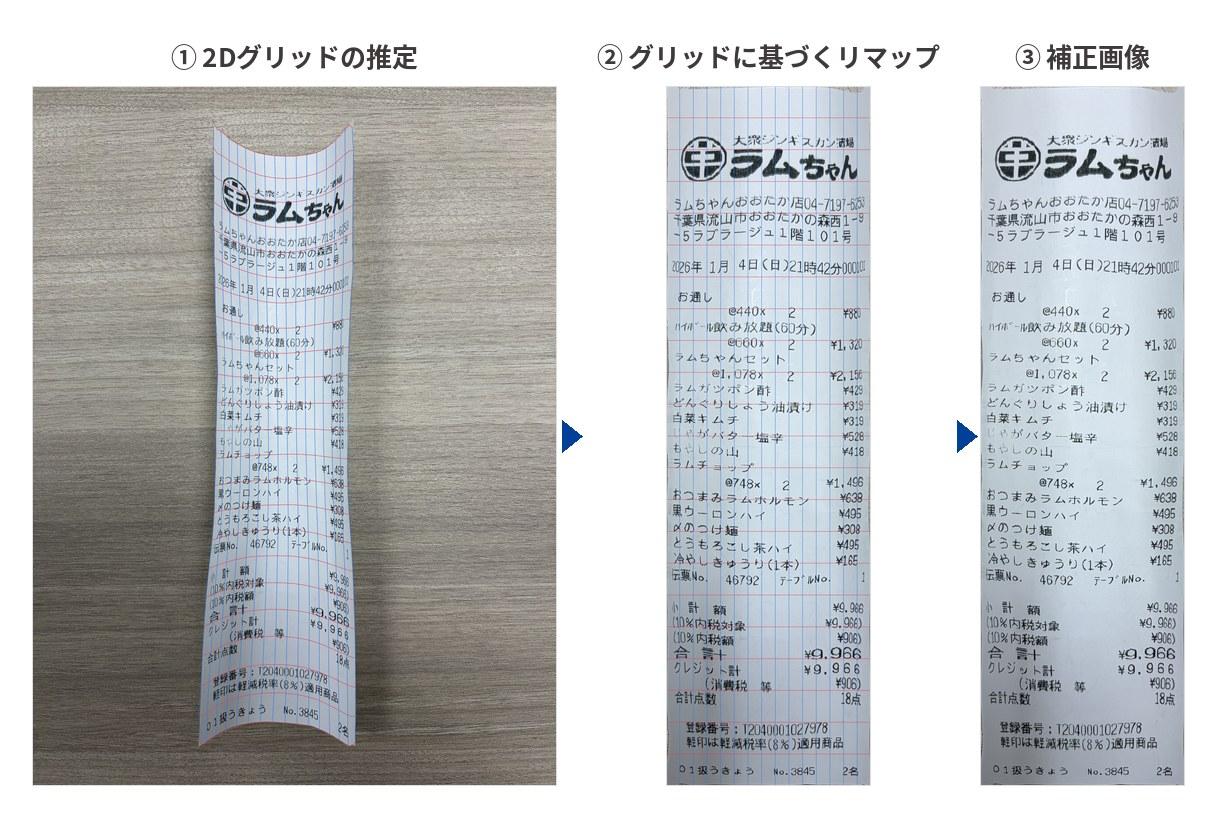
実際の写真に適用すると、次のようになります。推定した2Dグリッドが紙の曲がりに沿っており、リマップによって文字行がまっすぐな補正画像が得られます。
この方式には、次のような利点があります。
- 非線形な歪みを表現できる:紙の四隅の対応だけを使う射影変換では、紙の湾曲やカールを補正できません。格子点ごとに対応を推定するため、場所によって曲がり方が異なる紙も表現できます。
- 計算量を抑えられる:画素ごとの対応を直接推定するのではなく、粗い格子の対応を推定して補間するため、少ない計算量で補正できます。
- 紙の3次元形状を学習に活用できる:2Dグリッドに加えて3Dグリッドを同時に推定することで、紙の形状に関する手がかりがモデルに与えられ、学習が安定しやすくなります。
一方で、UVDocは1枚の写真に1枚の紙が写っていることを前提としています。そのため、見開きや並べた書類を区別できず、紙の外側の背景も補正の対象に含まれます。また、推定したグリッドに細かな揺らぎが生じ、本来はまっすぐな文字行が波打って補正されることがありました。
PageNetV2の技術的な概要
アーキテクチャ
PageNetV2は、写真全体から特徴を抽出する特徴抽出器と、その特徴マップを共有する3つのブランチで構成した独自のモデルです。UVDocの公開モデルは日本語の文書向けにチューニングされていないため、PageNetV2はUVDocの学習済みモデルを流用せず、モデルの設計から学習までスクラッチで構築しています。
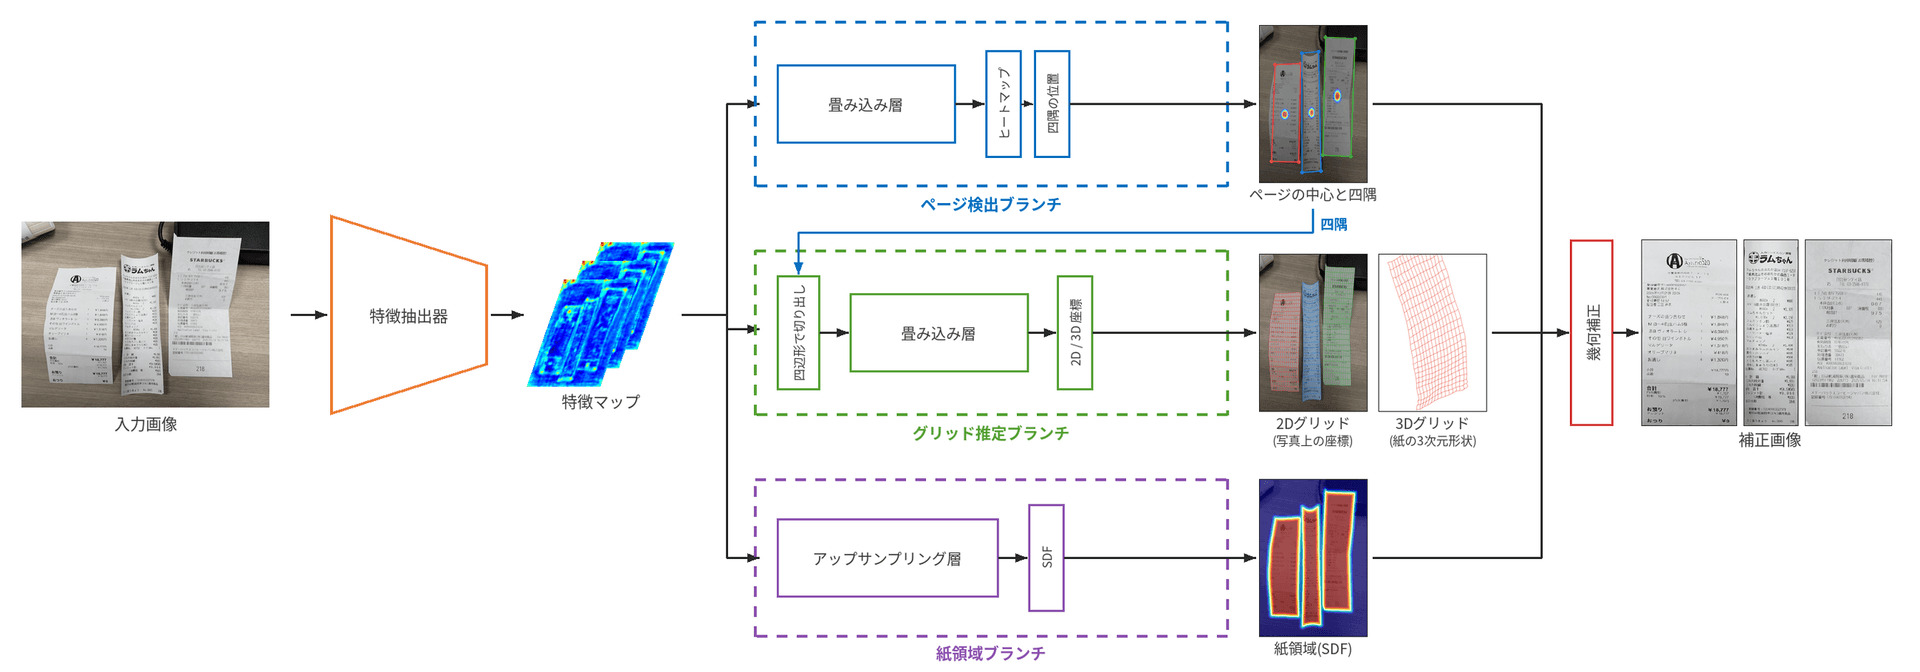
- 特徴抽出器:写真全体から特徴マップを抽出します。3つのブランチがこの特徴マップを共有するため、写真に写った書類の枚数によらず、特徴抽出は1回で済みます。
- ページ検出ブランチ:物体検出手法CenterNetを参考に、ページの中心を表すヒートマップと、ページの四隅の座標を推定します。これにより、写真内の書類を1枚ずつ検出します。
- グリッド推定ブランチ:UVDocを参考にした部分です。検出した四隅で囲まれた領域の特徴をページごとに切り出し、2Dグリッドと3Dグリッドを推定します。2Dグリッドは補正画像の生成に、3Dグリッドは入力が撮影された紙かスキャン画像かの判別に使います。あわせて、各格子点が画像内に写っているか(可視性)も推定し、画像の外に見切れたページで補正する範囲を決めるために使います。
- 紙領域ブランチ:各画素について紙の内側か外側か、および紙の縁からの距離をSDF(Signed Distance Field:符号付き距離場)として推定します。紙と背景の境界を精度よく求めるために使います。
モデルが推定する情報
推定結果を可視化すると、次のようになります。この例では、机の上に並べた3枚のレシートの写真から、各レシートの中心と四隅、2Dグリッド、紙領域、3Dグリッドを推定しています。
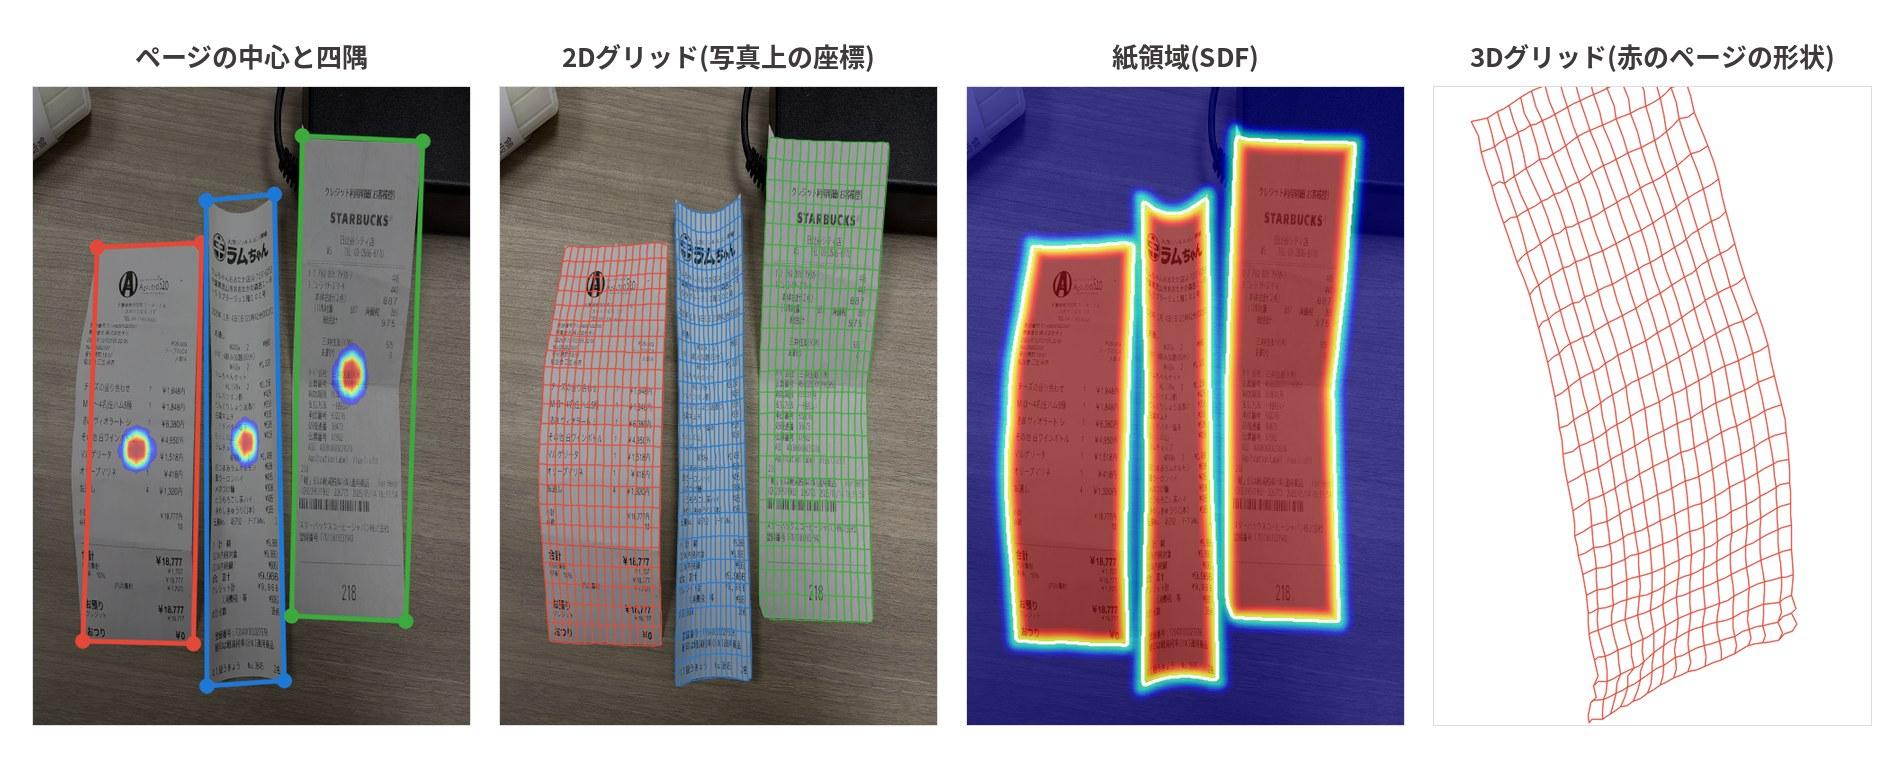
これらの推定結果をもとに、ページごとに補正画像を生成します。まず3Dグリッドから、入力が撮影された紙(湾曲や遠近の歪みを含む)か、スキャン画像やPDFのような平面の文書かを判別します。真上から撮影した平らな紙も、平面の文書として扱います。スキャン画像の場合は、文字行や罫線から傾き角を推定し、回転のみで補正します。撮影された紙の場合は、2Dグリッドに基づくリマップで平面の画像に変換します。いずれの場合も、紙領域をもとに書類の部分(前景)だけを切り出して補正するため、机や隣の書類など背景の文字は解析の対象になりません。
スキャン画像やPDFのように、もともと平面の文書にグリッドによる補正を適用すると、わずかな推定誤差によって直線が曲がることがあります。回転のみで補正することで、直線を保ったまま、元の解像度で傾きを補正できます。
最適化の方針
グリッドによる補正では、格子点ごとの座標誤差が小さくても、補正画像の品質が高いとは限りません。誤差の大部分はページ全体の位置や形状のずれとして現れる一方、グリッド内部の局所的な揺らぎは平均誤差にほとんど反映されないためです。しかし、OCRにとってはこの局所的な揺らぎが文字行の波打ちや字間の伸縮となり、認識精度の低下につながります。
そこでPageNetV2では、次の3つの観点を両立する独自の目的関数を設計しました。
- ページ全体の補正(マクロ):紙面の境界、つまりページの輪郭をアンカーとして、ページ全体の位置、形状、向きを正確に推定します。グリッド全体の歪みや、紙の外側へのはみ出しを抑制します。
- グリッド内部の精度(ミクロ):補正後の格子点の間隔や並びが均等かつ直線的になるように、局所的な予測精度を高めます。
- 読み取りを妨げない補正:文字行や罫線が水平な直線として復元されること、字間や表のセル幅が不自然に伸縮しないことを重視します。OCR、レイアウト解析、表構造解析の精度を損なわない補正を目指しています。
あわせて、ページ検出、各格子点の可視性(画像内に写っているかどうか)、紙領域も同時に学習します。これにより、ページの分割から補正までに必要な情報を、1つのモデルでまとめて推定できます。
UVDocからの変更点
PageNetV2は、UVDocのグリッド推定の考え方を引き継ぎつつ、ページ検出と紙領域の推定を加えています。主な違いは次のとおりです。
| UVDoc | PageNetV2 | |
|---|---|---|
| 1枚の写真で扱える書類 | 1枚(写真全体を1ページとして補正) | 複数(ページを検出し、1枚ずつ補正) |
| グリッドの推定方法 | 写真全体の特徴マップから直接回帰 | 検出したページごとに特徴を切り出して回帰 |
| 推定する情報 | 2Dグリッド、3Dグリッド | ページの中心と四隅、2Dグリッド、3Dグリッド、紙領域(SDF) |
| 背景の扱い | 机や隣の書類などの背景も含めて補正 | 紙領域を推定し、書類の部分(前景)だけを切り出して補正 |
| スキャン画像の扱い | 撮影された紙と同じくグリッドで補正 | 3Dグリッドから撮影された紙かスキャン画像かを判別し、スキャン画像は回転のみで傾きを補正 |
| 学習の目標 | 格子点の座標と3次元形状の回帰が中心 | 回帰に加え、ページ境界の厳密な精度、グリッド構造の制約、OCRやレイアウト解析の精度を損なわない補正を重視 |
PageNetV2でできること
ここからは解析例を紹介します。検出したページとグリッドの図では、ページごとに色を変えてグリッドを描画しています。
ページ分割と写真内の複数の書類の識別
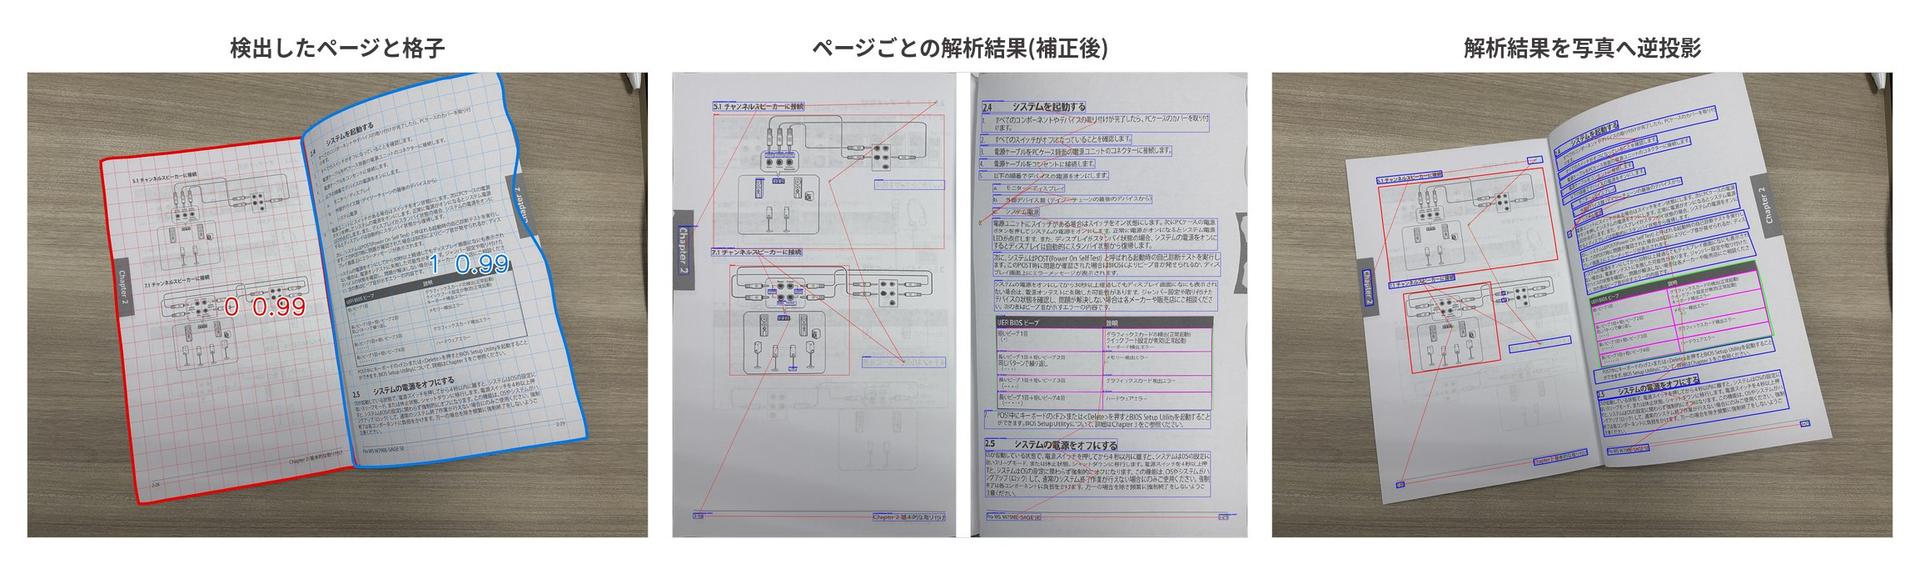
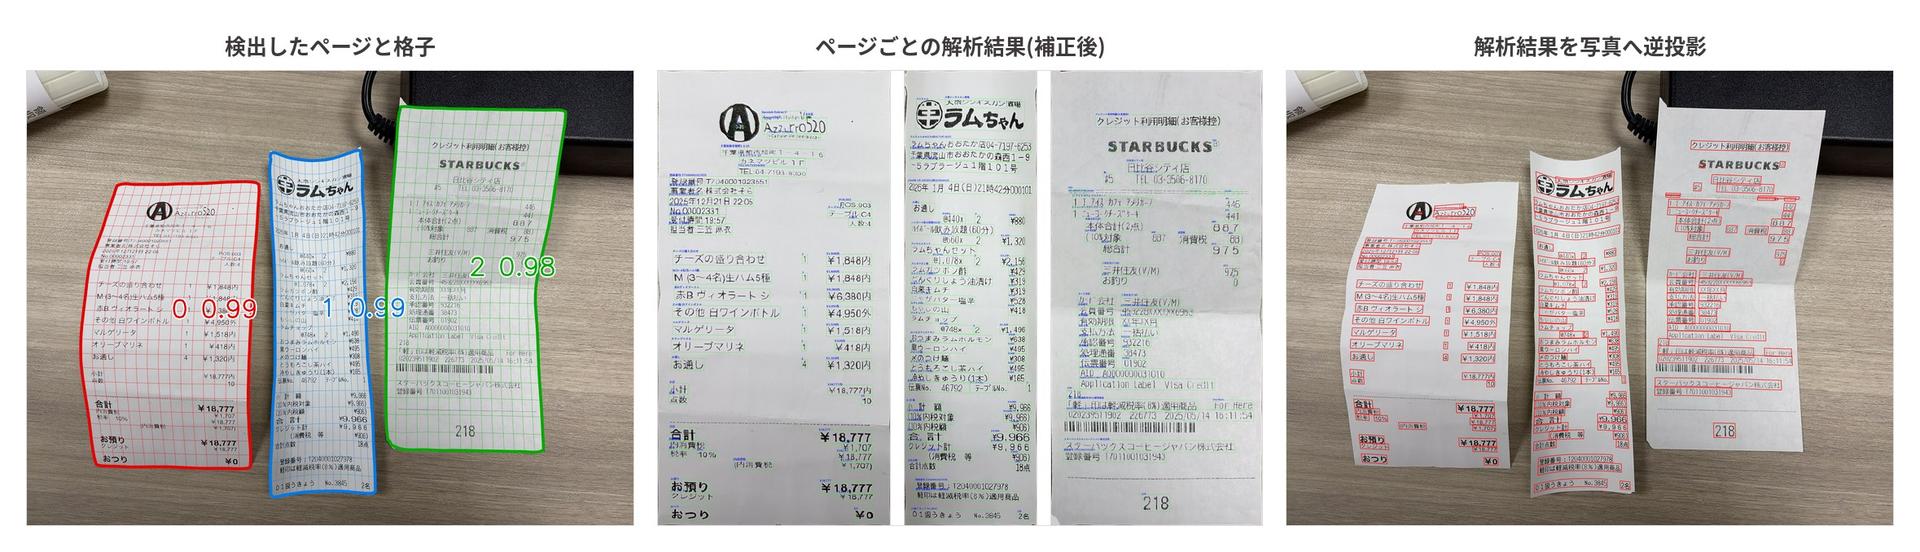
1枚の写真に写った複数の書類を1枚ずつ検出し、それぞれを独立したページとして解析します。見開きの冊子は綴じ部分で左右のページに分割し、並べたレシートは1枚ずつ切り出します。
湾曲した書類の歪み補正
紙の湾曲やカールのような非線形な歪みも、2Dグリッドに基づくリマップで平面の画像に補正します。補正後の画像では文字行が直線になるため、OCRで行単位に文字列を認識できます。
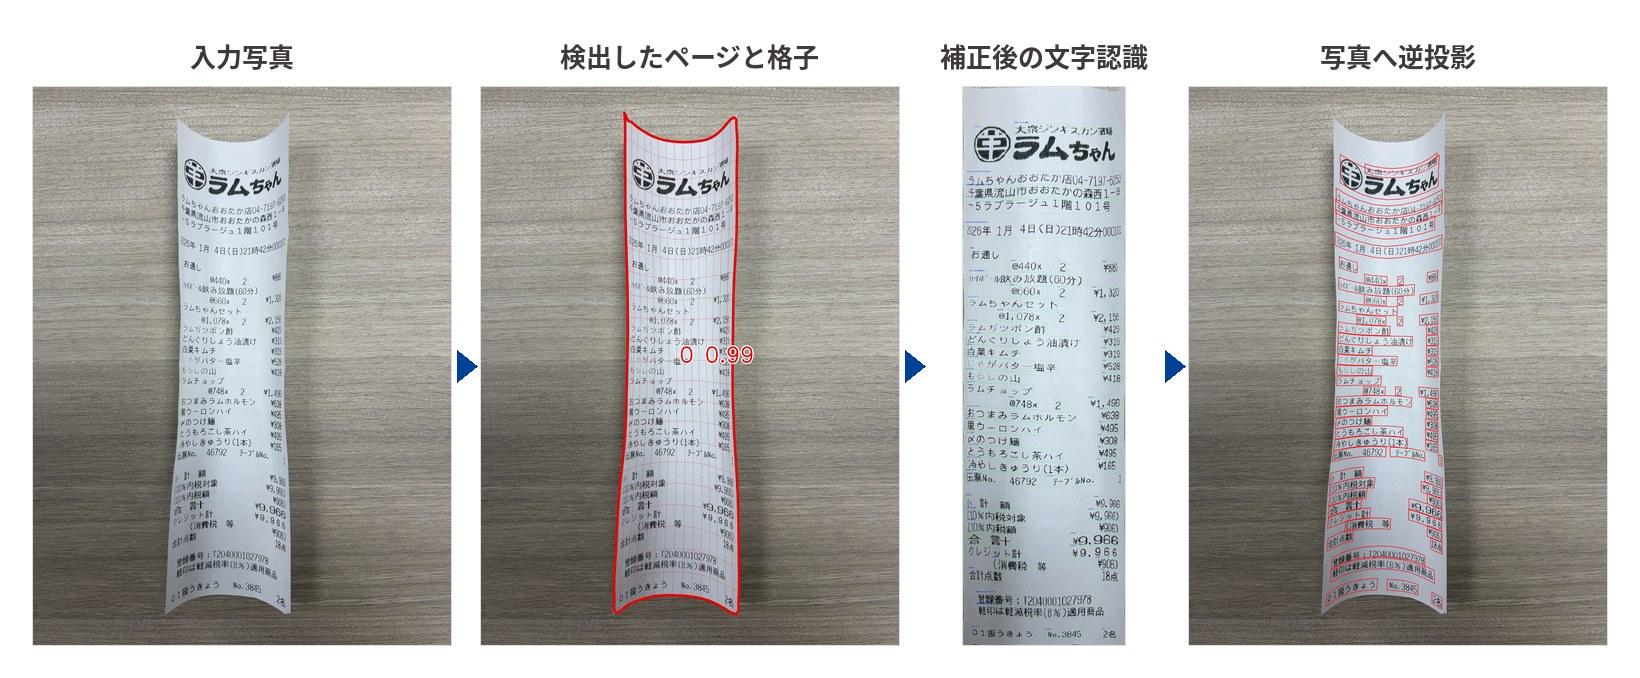
逆投影した結果では、補正後の画像上の矩形が、元の写真上では紙の曲がりに沿ったポリゴンになります。写真上の座標が必要な用途でも、補正後の画像で得た解析結果をそのまま利用できます。
スキャン画像の傾き補正
スキャン画像やPDFは、撮影された紙ではなく平面の文書であると判別し、回転のみで補正します。回転角は、ページ内の文字行や罫線から推定します。
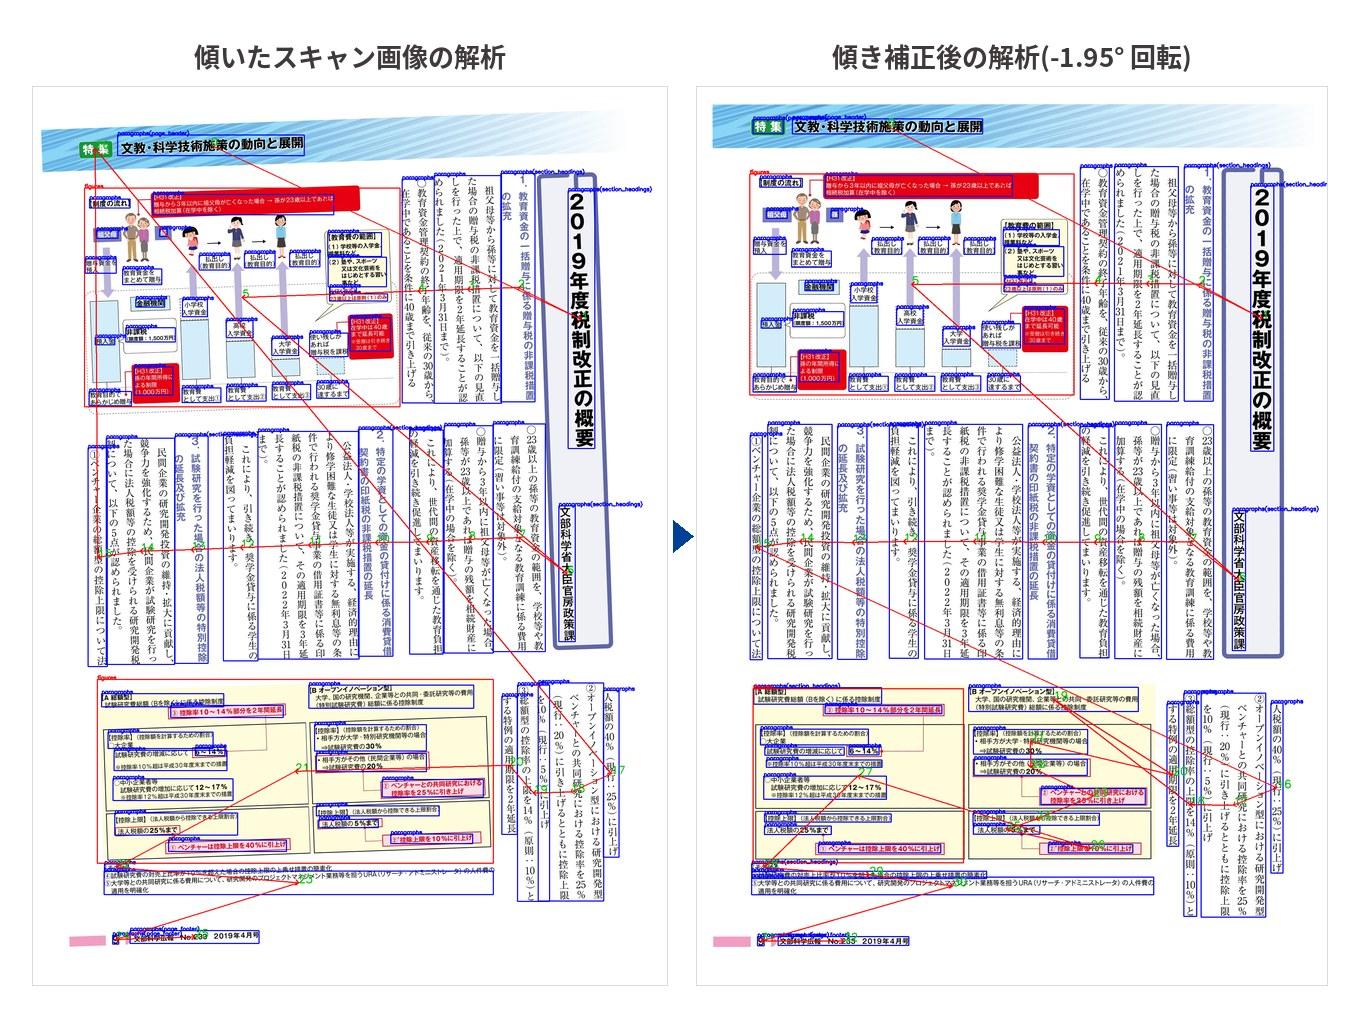
グリッドによる非線形な補正を行わないため、罫線や表の枠は直線のまま保たれます。また、拡大や縮小を伴わないため、元の解像度のまま補正できます。
写真や傾いた画像のレイアウト解析
レイアウト解析と表構造解析も、補正後の画像に対して行います。前掲の見開きの冊子の例では、段落、図、表をページごとに抽出し、ページ内の読み順も推定しています。補正せずに解析した場合は傾いた段落の領域どうしが重なっていましたが、補正後は段落や表の領域がページの行や列に沿って推定され、左右のページも別々に扱われます。
文字認識と背景の文字の除去
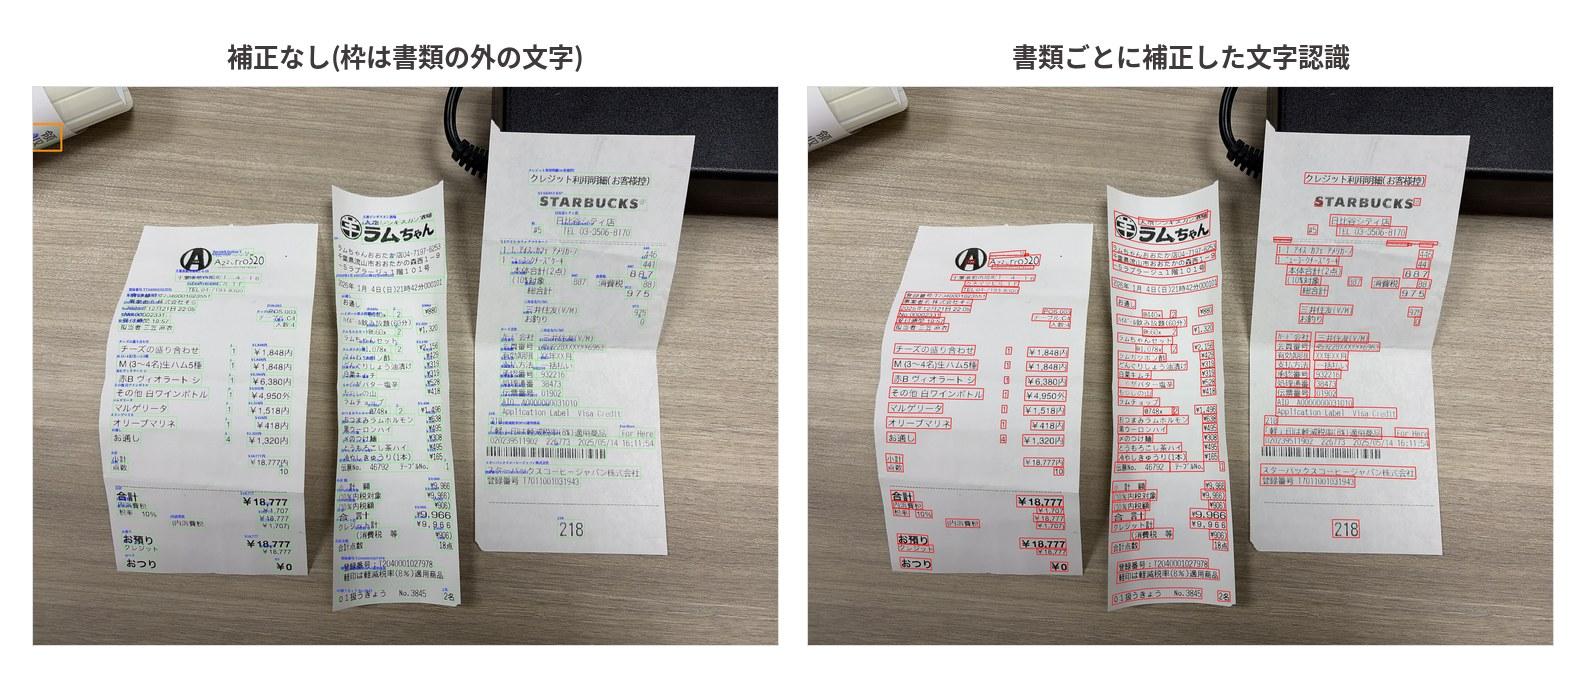
写真には、対象の書類以外の文字が写り込むことがあります。次の例では、補正せずに解析すると、写真の左上に置かれた物に印字された文字まで認識してしまいます(左図のオレンジ色の枠)。PageNetV2は紙領域を推定し、書類ごとに補正してから解析するため、レシートに書かれた文字だけを認識できます。
使い方
PageNetV2は、YomiToku v0.16.3以降で幾何補正のデフォルトモデルとして利用できます。CLIやPython APIで指定するモデル名は pagenet_v2 です。
CLI
--dewarp を指定すると、解析の前処理として幾何補正を行います。
yomitoku ${path_data} -v --dewarp
| オプション名 | 説明 |
|---|---|
--dewarp | 幾何補正を有効にします |
--dewarp_coordinate | 出力座標を指定します。dewarped:補正後の画像の座標(デフォルト)、photo:元の画像の座標 |
--dewarp_model | 幾何補正モデルを指定します。pagenet_v2(デフォルト)、pagenet_v1、uvdoc_v1 から選べます |
補正後の画像は *_dewarped.jpg として保存されます。-v を指定すると、検出したページとグリッドを描画した *_dewarp_grid.jpg も出力されます。1枚の画像から複数のページが検出された場合は、ページごとに *_p1_1.*、*_p1_2.* のように、左から右、上から下の順で番号を付けて出力します。
解析結果を元の画像の座標で受け取る場合は、--dewarp_coordinate photo を指定します。各要素に元の画像上のポリゴン polygon が付与され、box はその外接矩形になります。
yomitoku ${path_data} -f json -v --dewarp --dewarp_coordinate photo
補正の結果は、JSONの preprocess.dewarp に記録されます。スキャン画像と判別して回転のみで補正した場合は、flat が true になり、rotation に回転角(度、反時計回りが正)が入ります。グリッドが潰れたページ、より大きなページの内側に検出されたページ、画像の外に大きく見切れたページは、補正と解析の対象から除外します。ページが1枚も検出されなかった画像は、補正せずに元の画像のまま解析を続けます。
Python API
DocumentAnalyzer に enable_dewarp=True を指定します。写真に写ったすべてのページを解析するには、analyze_pages を使います。ページごとの (results, ocr_vis, layout_vis) のリストが、左から右、上から下の順に返ります。
import cv2

from yomitoku import DocumentAnalyzer
from yomitoku.data.functions import load_image

analyzer = DocumentAnalyzer(
    visualize=True,
    device="cuda",
    enable_dewarp=True,
    dewarp_coordinate="dewarped",  # "photo"を指定すると、解析結果を元の画像の座標で返す
)

img = load_image("photo.jpg")[0]
outputs = analyzer.analyze_pages(img)

# 検出したページとグリッドを元の画像に描画する
cv2.imwrite("dewarp_grid.jpg", analyzer.preprocessor.dewarper.visualize(img))

for k, (results, ocr_vis, layout_vis) in enumerate(outputs):
    dewarp = results.preprocess.dewarp
    print(dewarp.status, dewarp.page, dewarp.num_pages, dewarp.flat, dewarp.rotation)
    cv2.imwrite(f"page_{k}.jpg", analyzer.processed_imgs[k])  # 解析に使った補正後の画像
    results.to_json(f"page_{k}.json")
補正だけを行う場合は、PageDewarper を単体で利用できます。検出したページごとに、(結果, 補正後の画像) のリストが返ります。
import cv2

from yomitoku import PageDewarper
from yomitoku.data.functions import load_image

dewarper = PageDewarper(device="cuda")
img = load_image("photo.jpg")[0]

for results, dewarped_img in dewarper(img):
    if results.status == "ok":
        cv2.imwrite(f"dewarped_{results.page}.jpg", dewarped_img)
YomiToku Studio
インストールせずに試す場合は、ブラウザで動作するYomiToku Studioを利用できます。画像は外部のサーバーへ送信されず、すべてお使いのPC上で処理されます。
- YomiToku Studioを開き、上部パネルの「幾何補正」をオンにします。
- 撮影した写真やスキャン画像を追加して解析します。
- 画像ビュー右下の「補正後|補正前(写真)」で、補正後の画像と元の写真を切り替えて結果を確認できます(Gキーでも切り替えられます)。
1枚の写真から複数の書類が検出された場合は、書類ごとに解析します。ページは、画像ビュー左下の「写真内のページ」のタブで切り替えられます。また、左の操作レールの「Export」で「座標」を「補正前(写真)」にすると、元の写真の座標で解析結果を出力できます。
YomiToku Studio
インストール不要で、ブラウザからすぐにYomiTokuの認識精度をお試しいただけるデモサイトです。
画像やPDFは外部サーバーへアップロードされず、すべてお手元のPC内で処理されます。
※ブラウザ上で処理を行うため、通常版と比較して処理速度は遅くなります。
まとめ
YomiToku v0.16.3の幾何補正モデルPageNetV2では、撮影した書類をそのまま解析できるように、次の機能を提供しています。
- 1枚の写真に写った複数の書類(見開きの左右のページ、並べたレシートなど)を1枚ずつ検出し、ページごとに解析します。
- 紙の湾曲やカールのような非線形な歪みを、グリッドによる補正で平面の画像に変換します。
- スキャン画像やPDFは、回転のみで傾きを補正します。
- 紙領域を推定し、背景や隣の書類の文字を解析の対象から除外します。
- 補正後の画像で得た解析結果を、元の写真の座標に変換できます。
PageNetV2は、既存研究UVDocのグリッドによる補正を土台に、CenterNetを参考にしたページ検出と、紙領域を捉えるSDFの推定を組み合わせたモデルです。学習では、ページ全体を捉えるマクロな補正と、グリッド内部のミクロな精度、さらにOCRやレイアウト解析の精度を損なわない補正の両立を目指しました。
スマートフォンで撮影した書類やスキャン画像を、そのまま解析にかけたい場面で、ぜひお試しください。ブラウザからすぐに試せるYomiToku Studioでも、幾何補正を利用できます。
公開版YomiToku
検証用途では、GitHubで公開されているYomiTokuを試用できます。
まずはブラウザでお試しください
無料Web版はインストール不要です。高速・高精度な解析には、 お客様の環境で稼働するYomiToku Proを接続できます。
ご利用前にYomiToku Studio利用規約をご確認ください。