
YomiTokuの文字認識モデルv5では、認識対象を7,519文字へ拡張し、特殊文字の正規化、低頻度文字、手書き縦書きの認識精度を改善しました。文字カバレッジと手書きOCRの評価結果を紹介します。
日本語の文字は多種多様でひらがな、カタカナ、漢字、記号、アルファベット、数字などがあり、用途に応じて幅広い文字を読み取る必要があります。また、OCRには、画像中の文字を単純に変換するだけでなく、文書が持つ意味を崩さずに出力することが求められます。たとえば、丸数字の「①」を「1」に変換すると、項目番号と本文中の数字を区別できなくなる場合があります。「①1月1日」を「11月1日」と出力すれば、1番目の項目に書かれた日付が、別の日付に見えてしまいます。また、人名に使われる珍しい漢字は一般的な文章にはほとんど現れませんが、氏名を読み取る場面では欠かせません。
YomiTokuの文字認識モデルv5では、従来の課題に対応し、多種多様な文字をより正確に読み取るために、次の3点を改善しました。
- 文字の正規化ルールとモデルが認識する文字集合の見直し
- 低頻度文字に対する認識精度の改善
- 手書きの縦書きに対する読み取り精度の改善
本記事では、tiny v4とtiny v5の比較を通して、v5で何が改善されたかを紹介します。
文字の正規化ルールとモデルが認識する文字集合の見直し
文字セット選定の変更
v5では認識対象の文字セットを見直し、認識対象文字種をv4の7,114文字から7,519文字へ拡張しました。YomiTokuが対象とする文書に出現し得るすべての文字を、そのまま認識対象にしているわけではありません。半角カタカナや全角英数字のように、意味や文書の取り扱いを考慮して正規化でまとめる文字や、対象外とする外国語文字を独自に選定しています。日本語文書の読み取りユースケースをもとに、文字セットと正規化ルールを決定しています。
7,519は、モデルが直接出力する文字の種類数です。半角カタカナや全角英数字などは、正規化後の文字として読み取るため、モデルが直接出力する文字集合に含まれない入力表記も扱えます。したがって、7,519は画像から読み取り可能な入力文字の総数を表すものではありません。
特殊文字の読み取りと正規化
従来は、認識結果にNFKC正規化を一括適用していました。NFKCは表記揺れを減らせるため、検索や集計には便利です。一方で、文書中で保持すべき表記上の区別まで失われることがあります。
たとえば、NFKCでは次のような変換が行われます。
- 丸数字の「①」は「1」になる
- 上付き数字の「²」は「2」になる
- ローマ数字の「Ⅱ」は「II」になる
- 単位記号の「㎡」は「m2」になる
変換後の文字列が同じ意味を表す場合でも、項目番号、指数、章番号、単位といった文書中の役割まで同じとは限りません。
そこでv5では、一括したNFKC正規化をやめ、文字ごとに「そのまま保持する」「別の文字へ正規化する」「複数の文字へ展開する」という読み取りポリシーを定義しました。
| 表記の種類 | v5での扱いの例 | 目的 |
|---|---|---|
| 丸数字 | ①1月1日 → ①1月1日 | 項目番号と日付を区別する |
| 組文字 | ㌻ → ページ、㌔ → キロ | 字形を認識したうえで、同じ意味の文字列へ展開する |
| ローマ数字 | Ⅰ、Ⅱ、Ⅲを保持 | 章番号や科目番号の表記を残す |
| 単位記号 | ㎡、㎥、℃、ℓを保持 | 単位の表記を残す |
| 人名などの異体字 | 﨑、髙を保持 | 固有名詞の字形の違いを残す |
| 法人記号・合字 | ㈱ → (株)、fi → fi | 認識後に対応する文字列へ展開する |
| 全角英数字・半角カナ | A → A、1 → 1、カ → カ | 意味を変えない表記揺れをまとめる |
組文字や合字は、モデルが画像中の字形を一つの文字として認識した後、対応する文字列へ展開します。すべてを元の字形のまま残すのでも、一律に通常の文字へ置き換えるのでもなく、文字の役割に応じて扱いを分けています。なお、表はv5における文字の扱いを示したものであり、掲載した文字がすべてv5で新たに追加されたという意味ではありません。
平均精度だけでは評価できない低頻度文字の読み取り
文書中の文字の出現頻度には、大きな偏りがあります。数字やひらがな、アルファベットなどが繰り返し出現する一方で、特定の記号や漢字はほとんど出現しません。
弊社が収集している実データを分析すると、空白、記号、文字化け由来の文字なども含めて18,674文字種が出現しました。このうち、出現頻度の高い上位1,620文字種だけで、延べ出現数の99%を占めています。文字種では全体の約8.7%です。
残る17,054文字種は、種類としては全体の約91.3%を占めますが、延べ出現数を合計しても約1%にすぎません。このことから、文書内の文字の出現頻度には大きな偏りがありますが、低頻度に出現する文字の種類が多数含まれるロングテールな分布であることがわかります。
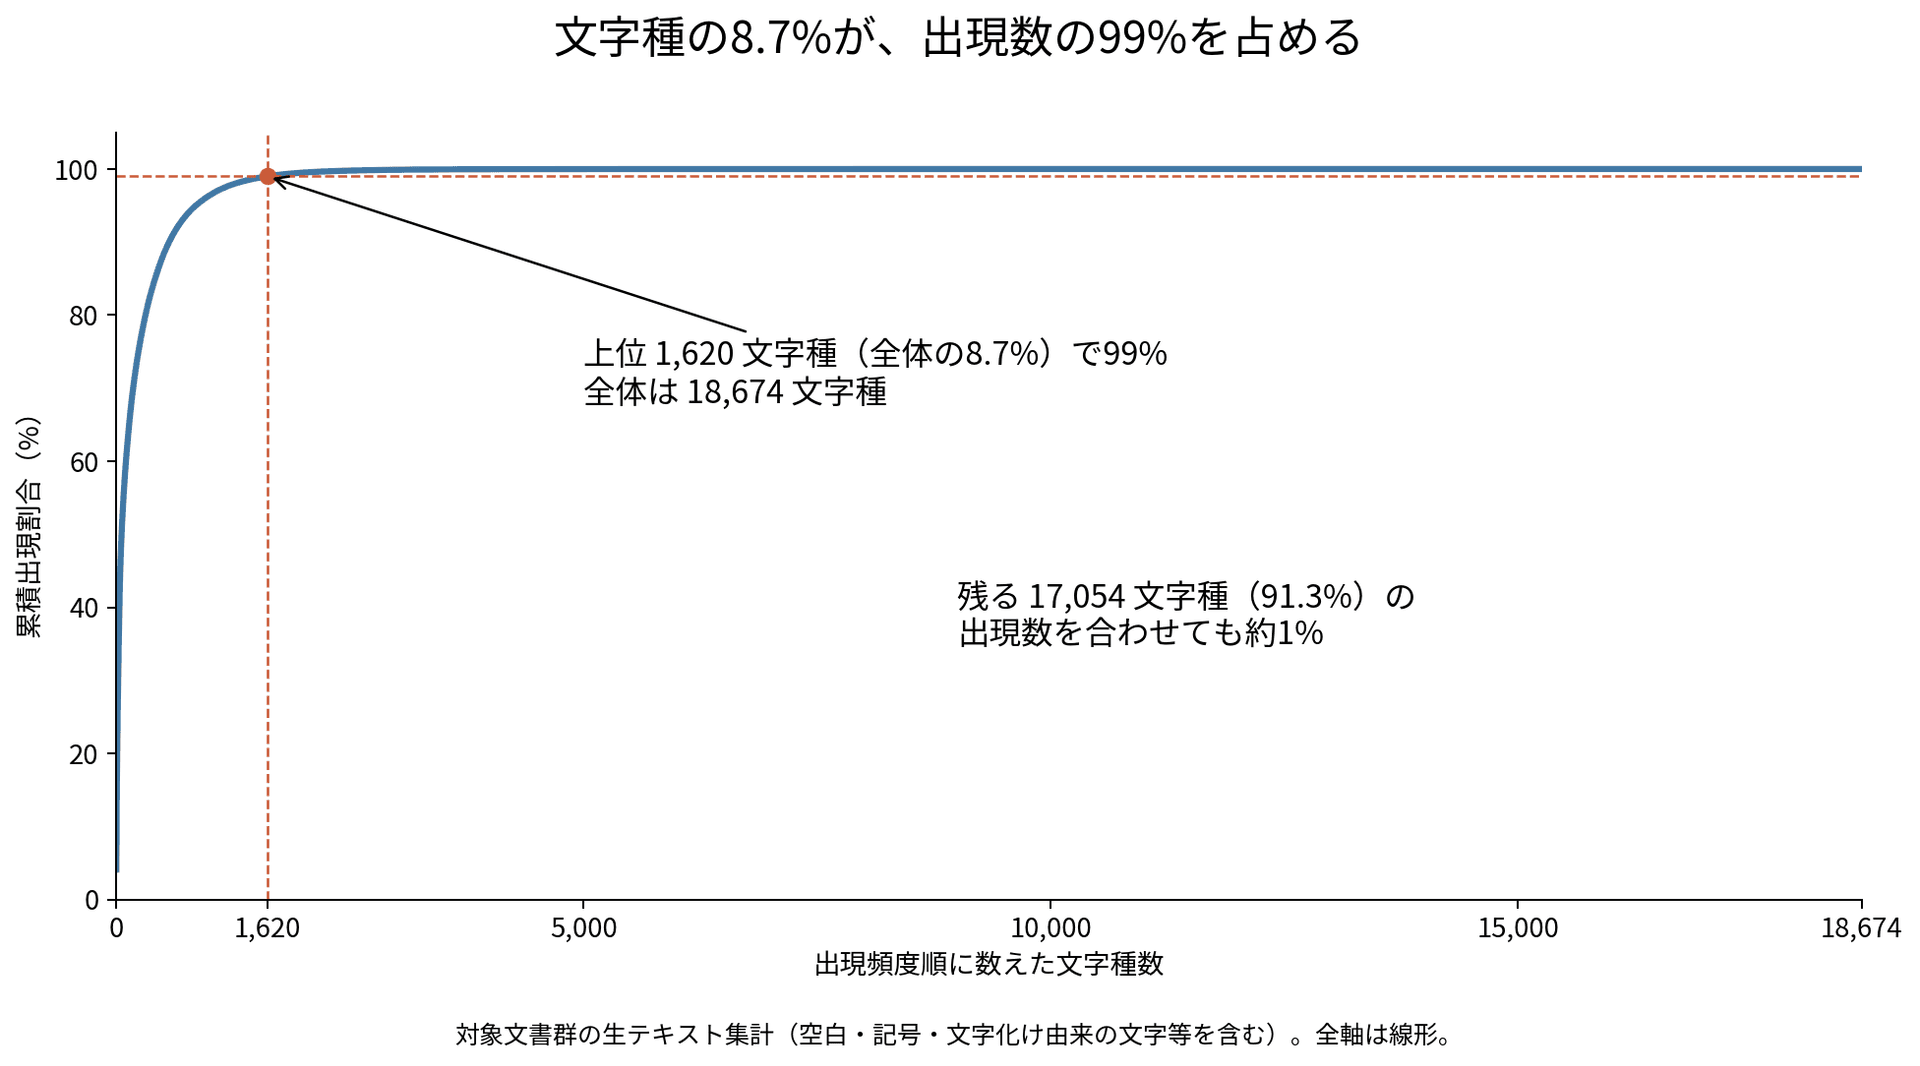
図の横軸は出現頻度の高い順に数えた文字種数、縦軸は累積出現割合です。上位1,620文字種の時点で99%に達していることが分かります。
この分布では、上位1,620文字種だけを完全に認識し、それ以外をすべて誤認識したとしても、出現数で重み付けした文字正読率は理論上約99%になります。つまり、平均精度の高さと、認識できる文字の広さが必ずしも一致しないことが分かります。
しかし、平均精度が99%であっても、残りの文字を読めなくてよいわけではありません。氏名や地名に含まれる異体字、専門文書で使われる記号、番号や単位の表記は、出現頻度が低くても、読み誤ると実務上の問題につながります。
v5では、認識対象に文字を追加するだけでなく、低頻度文字についても実際の認識性能を高めることを重視し、平均精度だけでは捉えにくい低頻度文字の認識改善に取り組みました。
文字単位の評価でカバレッジを測定
CERだけでは捉えにくい改善
OCRの代表的な評価指標であるCER(Character Error Rate)は、次式で表されます。
ここで、Sは置換、Dは削除、Iは挿入、Nは正解文字列の延べ文字数です。
CERは文書全体で発生する誤りの量を測るうえで重要な指標です。ただし、文字の出現頻度をそのまま反映するため、頻出文字の改善は値に大きく表れる一方、低頻度文字の誤りは全体に埋もれます。
そこで今回はCERに加えて、文字種ごとの正読率を等しい重みで集計するカバレッジ評価を行いました。
カバレッジの評価方法
評価対象文字の集合をC、文字cを評価する画像群をE_cとします。画像iの正解文字列をy_i、予測文字列をp_iとし、正解に含まれるcの出現数をn_c(y_i)、正解と予測の対応付けで一致したcの数をh_c(y_i,p_i)とします。
文字cの正読率a_cと、文字種を等しい重みで平均したmacro正読率A_macroを、次のように定義します。
さらに、文字ごとの正読率がしきい値τ以上となった文字種の割合を、カバレッジとして次のように定義します。
今回はτ=0.90とし、文字別正読率が90%以上となった文字種の割合をカバレッジとして評価しました。簡単に言えば、まず文字ごとに正読率を求め、それらを同じ重みで平均して文字の頻度によらず認識率を評価したものがmacro正読率、十分な正読率に達した文字種の全体に対する網羅率を算出したものがカバレッジです。頻出文字も低頻度文字も一つの文字種として平等に扱うため、出現頻度に左右されにくい形で、認識できる文字の網羅性を確認できます。
tiny v4とtiny v5の比較
評価には、実文書由来の96,358サンプルを使用しました。各サンプルには評価対象の文字が指定されており、正解と予測を照合して、その文字を正しく認識できたかを集計しています。評価セットに含まれる4,859文字種のうち、評価サンプルが10件未満の26文字種を除外し、4,833文字種を比較対象としました。
この評価で7,519文字種すべてを対象としていないのは、実データへの出現が極端に少なく、評価用の実画像を確保できない文字があるためです。評価できない文字も認識精度の改善対象に含めていますが、今回の結果から実画像に対する精度まで確認できたとはみなしません。
低頻度文字で25.4ポイント改善
v5用の正解ラベルと各モデルの生出力を比較した結果を示します。この比較には、モデル自体の認識性能だけでなく、v4とv5の正規化仕様の違いも含まれます。
| 対象文字群 | 文字種数 | tiny v4 | tiny v5 | 改善幅 |
|---|---|---|---|---|
| 全照合文字(評価10件以上) | 4,833 | 80.4% | 96.8% | +16.4pt |
| 各文字の出現頻度が0.001%以下 | 2,983 | 69.8% | 95.2% | +25.4pt |
| 頻出上位1,620文字を除く低頻度文字 | 3,265 | 71.9% | 95.5% | +23.6pt |
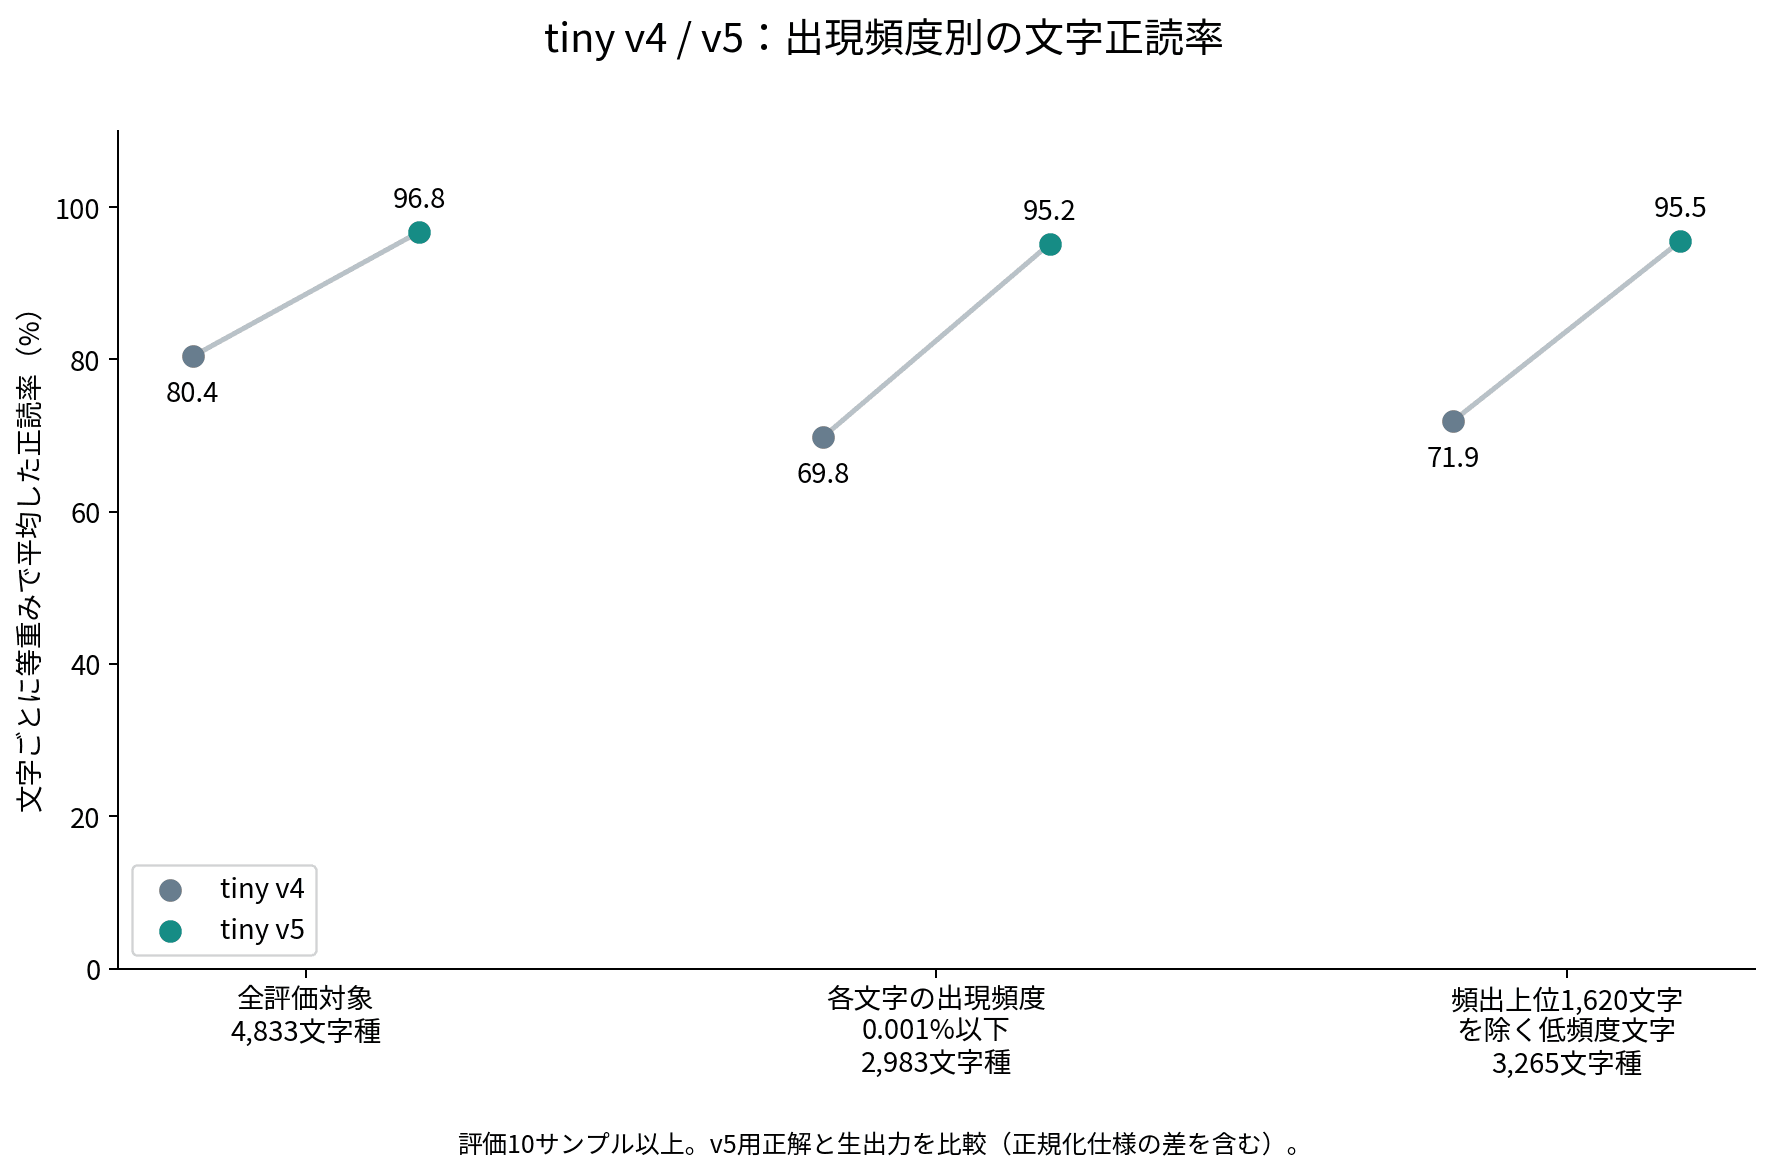
文字の実測出現頻度と評価結果をコードポイント単位で照合すると、1文字あたりの出現頻度が0.001%以下の文字は2,983文字種ありました。この文字群のmacro正読率は、69.8%から95.2%へ25.4ポイント改善しています。
また、頻出上位1,620文字を除いた低頻度文字では、評価サンプルを10件以上確保できた3,265文字種を比較しています。macro正読率は71.9%から95.5%へ、23.6ポイント改善しました。
全照合文字での改善幅が16.4ポイントであるのに対し、出現頻度0.001%以下の文字では25.4ポイント改善しています。v5では、従来精度が低かった低頻度文字の認識精度が大きく改善しました。
| 対象文字群 | tiny v4のカバレッジ | tiny v5のカバレッジ | 改善幅 |
|---|---|---|---|
| 全照合文字(評価10件以上) | 73.4% | 93.4% | +20.0pt |
| 各文字の出現頻度が0.001%以下 | 59.0% | 90.3% | +31.3pt |
| 頻出上位1,620文字を除く低頻度文字 | 62.0% | 90.9% | +28.9pt |
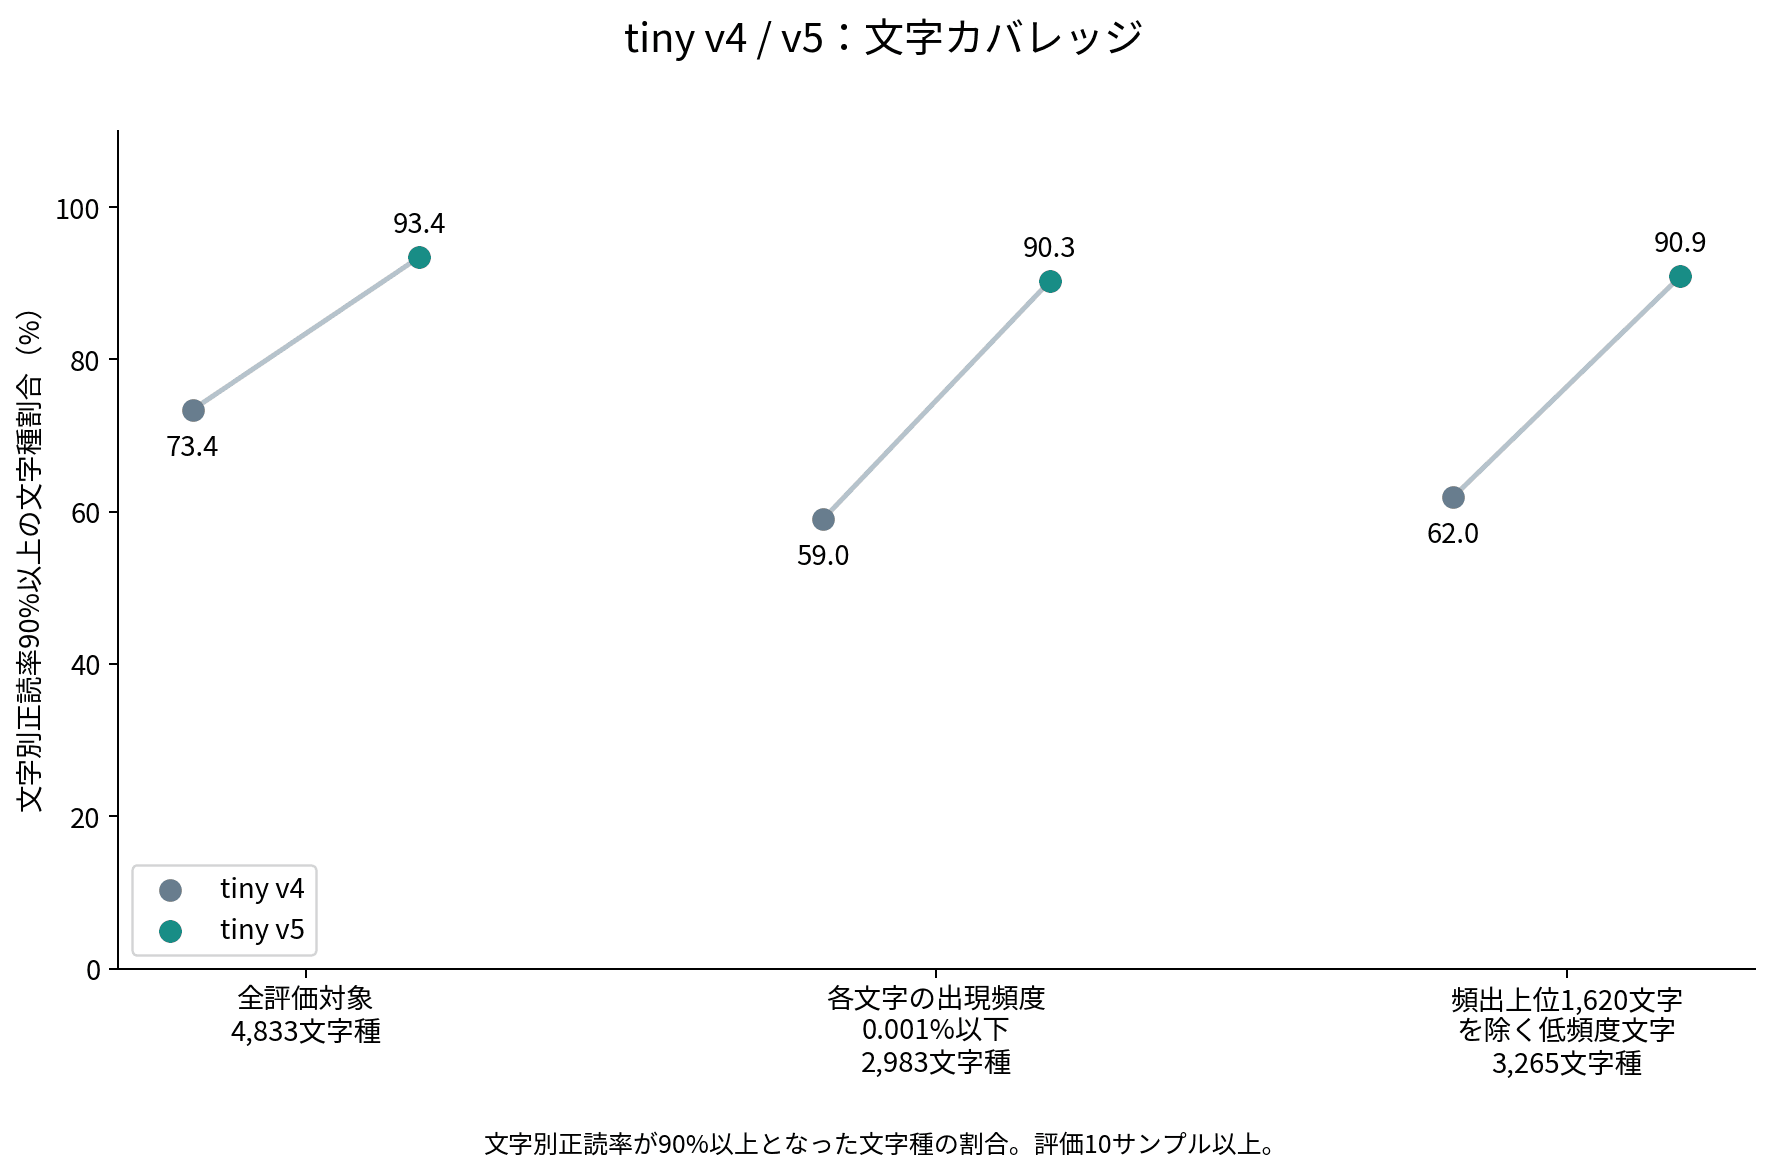
カバレッジは同じ文字群について、文字別正読率が90%以上となった文字種の割合を示します。出現頻度0.001%以下の文字では、正読率90%以上を達成した文字種が59.0%から90.3%へ増加しました。これは、一部の文字だけが大きく改善したのではなく、安定して読み取れる低頻度文字の網羅率が改善したことを示します。
手書きの縦書きにも対応を強化——GT BBOXによるRecognizer単独評価
従来のモデルでは、手書きの縦書きの読み取り精度に課題がありました。そこで、手書きの縦書きデータを追加収集し、認識精度の改善に取り組みました。
評価には、JaWildTextデータセットのhandwriting_ocrを使用しました。文字認識モデル(Recognizer)を公正に比較するため、tiny v4とtiny v5の両方に同じGT BBOX(正解の文字領域)を入力しています。文字検出器は使用せず、検出漏れや検出領域のずれの影響を除外したうえで、文字領域ごとの認識結果を1−CERとテキスト全体一致率で評価しました。
GT BBOXを用いたRecognizer単独評価では、縦書きの1−CERがtiny v4の92.88%からtiny v5の94.13%へ、約1.25ポイント向上しました。また、文字領域ごとのテキスト全体一致率は49.30%から53.45%へ、約4.15ポイント向上しました。
| 指標(縦書き) | tiny v4 | tiny v5 | 変化 |
|---|---|---|---|
| 1−CER | 92.88% | 94.13% | 1.25ポイント向上 |
| テキスト全体一致率 | 49.30% | 53.45% | 4.15ポイント向上 |
1−CERは、総編集距離を正解の総文字数で割ったCERを1から引いた値です。テキスト全体一致率は、1つの文字領域に含まれる文字列がすべて一致した割合です。正解と予測には共通の正規化を適用しています。1−CERとテキスト全体一致率はいずれも高いほど良い指標です。この評価では、縦書きについて両指標の改善を確認しました。
まとめ
YomiTokuの文字認識モデルv5では、以下のような改善を実施しています。
- 文字ごとの正規化ルールを導入し、丸数字、ローマ数字、単位記号、異体字などは表記を保持。組文字や合字は、字形を認識した後に対応する文字列へ展開
- 認識対象を7,519文字に拡張
- 出現頻度が0.001%以下の文字群で、文字macro正読率が69.8%から95.2%へ25.4ポイント改善
- 手書きの縦書きデータを追加収集し、JaWildTextのGT BBOXを用いたRecognizer単独評価で、縦書きの1 − CERが92.88%から94.13%へ改善
- CERに加えて、カバレッジ評価を用いて、低頻度文字の認識性能を評価
頻出文字を正しく読むことはもちろん重要です。一方で、氏名に含まれる異体字、帳票上の記号、専門文書の単位など、出現頻度が低くても失ってはいけない文字があります。
今回のアップデートでは、従来から取り組んできた幅広い文字の読み取りをさらに強化するため、正規化ルール、認識対象文字、学習データ、評価方法を見直しました。従来読めていた文字の読み取り精度は維持しつつ、低頻度文字や手書きの縦書きを含め、固有名詞や特殊表記が現れる文書にも対応できるよう、YomiTokuの読み取り範囲を拡大しています。なお、最新のv5 tinyモデルはYomiToku Studioにも反映していますので、お気軽にお試しください。
まずはブラウザでお試しください
無料Web版はインストール不要です。高速・高精度な解析には、 お客様の環境で稼働するYomiToku Proを接続できます。
ご利用前にYomiToku Studio利用規約をご確認ください。